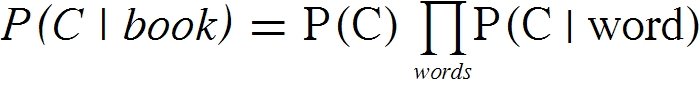Практические советы по реализации систем извлечения информации

Показаны сообщения с ярлыком classification. Показать все сообщения

воскресенье, апреля 15, 2007

РИТ-2007 и новости

Завтра будет первый день конференции РИТ-2007. В 18:00 я буду читать доклад про классификацию товарных предложений Яндекс.Маркета. Те, кто не идут на РИТ, смогут посмотреть среди прочих и мой доклад на сайте конференции (расписание трансляций).

После небольшой рекламы, хочу сказать еще несколько вещей:

  1. Блог после долгого перерыва возобновляет свою работу
  2. В ближайшее время я завершу серию постов "Введение в Text Mining"
  3. Будет несколько постов про базы данных, конкретно, как быстро вставлять очень много строчек в разные таблицы
  4. Расскажу про свои впечатления от Nutch и Hadoop
И самое важное. Нам в Яндекс нужны люди, хорошо знающие Java и с большим желанием заниматься text mining. На сайте вакансии пока нет — все вопросы можно и нужно задавать мне по адресу krondix@yandex-team.ru.

понедельник, декабря 18, 2006

Классификация документов

Продолжение серии "Введение в text mining".

С результатами автоматической классификации документов встречались, практически, все, кто пользовался электронной почтой. Спам-фильтры классифицируют входящую почту по двум категориям "спам"/"не спам" с помощью самых разных алгоритмов, начиная от простых decision trees задаваемых пользователем до сложных статистических методов. Далее мы рассмотрим несколько самых распространенных алгоритмов классификации и поймем как можно оценить и сравнить результаты работы этих алгоритмов.

Начнем с формулировки задачи. У нас есть некоторый набор категорий и документы, про которые известно, что они принадлежат одной из категорий. Пример: любой веб-каталог (Яндекс.Каталог, Yahoo Directory и другие), где сайты классифицированы по тематике. Эти документы составляют обучающую выборку для классификатора. Задача заключается в определении (точнее, предсказании с определенной вероятностью) категории для документов не входящих в обучающую выборку.

Очевидный способ классифицировать документ известный под названием алгоритм ближайшего соседа (nearest neighbour, NN) — найти в обучающей выборке наиболее схожий с ним и предположить, что их категории совпадают. В качестве меры похожести обычно используют расстояние или косинус угла между векторами. Самый простой в реализации, этот алгоритм оказывается и самым медленным, он линейно зависит от числа документов в обучающей выборке. На практике обычно используется модификация алгоритма ближайшего соседа — алгоритм k-ближайших соседей (k-nearest neighbours, k-NN). Здесь ищутся k наиболее близких документов из обучающей выборки и в качестве искомой категории выбирается встречающаяся чаще других в найденных документах. Так поступают, чтобы снизить влияние шума в обучающей выборке на результат. Шумом могут быть как просто неправильно классифицированные документы, так и документы, которые содержат много слов характерных для другой категории. Из-за невысоких показателей качества и, в первую очередь, низкой скорости алгоритм k-ближайших соседей редко применяется в промышленных разработках.

Следующий алгоритм, который мы рассмотрим, многие применяли и применяют в повседневной жизни. Создавая правило "always trust e-mails sent from address name@company.com" в почтовом клиенте, мы неявно управляем деревом принятия решений (decision tree), с помощью которого работают многие спам-фильтры. В нелистовых узлах дерева решений содержатся своего рода "вопросы" к документу, в листьях — ответы в виде результирующей категории. "Вопросы" могут задаваться самим пользователем, как в примере выше, так и вычисляться на основе обучающей выборки — в этом случае они обычно имеют вид "присутствуют ли в документе такие слова?" Простота идеи компенсируется сложностью построения такого дерева вопросов из набора документов, если интересно — напишу об этом отдельный пост. Кроме классификации, построенное дерево решений можно использовать для анализа структуры документов и категорий, что может может оказаться ценным само по себе. На практике, деревья решений используют в основном с этой целью, потому что по качеству классификации они сильно проигрывают классификаторам Байеса и линейным моделям, о которых пойдет речь дальше.

Про классификаторы Байеса я уже неоднократно писал, напомню основную идею. Для каждого слова мы считаем вероятность его принадлежности к каждой категории, вероятность принадлежности документа к категории считается как произведение вероятностей входящих в него слов. Несмотря на кажущуюся сложность такой формулы, по своей структуре это всего лишь линейная комбинация определенного числа параметров.

Здесь xi равно 1, если слово i присутствует в документе x, и 0 в противном случае. Таким образом задача классификации сводится к вычислению весов wi и смещения b для каждой категории и метод Байеса лишь один из многих способов их вычисления, причем не самый лучший. Заметим, что веса (wi,b) образуют гиперплоскость в пространстве слов, по одну сторону от которой лежат документы принадлежащие категории, по другую — не принадлежащие. Очевидно, что существует бесконечно много таких гиперплоскостей разделяющих документы из обучающей выборки. Идея, лежащая в основе метода опорных векторов (support vector machines, SVM), заключается в выборе разделяющей гиперплоскости, которая максимально удалена от всех документов. На данный момент, SVM считается самым точным алгоритмом классификации документов.

Для оценки качества классификации обычно используют следующий метод. Набор документов с известными категориями делят на две части: на одной обучаются, на другой тестируют. При этом предполагается, что документы, которые придется в будущем классифицировать, будут похожи на документы из тестовой выборки. Это, конечно, может оказаться совсем не так, но, к сожалению, другого способа оценить качество классификации пока нет. Общепринятыми характеристиками качества классификации являются точность и полнота. Точность вычисляется как отношение числа правильных положительных предсказаний классификатора (когда документу была присвоена какая-либо категория) к числу общему числу положительных предсказаний. Полнота это отношение числа правильных положительных предсказаний к числу документов, которым должна была быть присвоена категория. У классификаторов с высокой точностью, обычно, низкая полнота и наоборот. Например, если спам-фильтр работает с высокой точностью и низкой полнотой, он будет очень редко класть в папку spam хорошее письмо, но при этом некоторая часть спама может остаться в inbox. Для каждого алгоритма классификации, как правило, есть возможность управлять соотношением точность-полнота.

воскресенье, декабря 03, 2006

Что такое text mining

Решил написать небольшую серию постов, некоторое введение в text mining. Что это такое, какие задачи ставятся, как решаются, какие направления сейчас развиваются. Начну с общего обзора.

Text mining, в отличие от своего старшего брата data mining, сравнительно молодая область computer science, большинство значительных результатов было получено в последние 10-15 лет. Как мне кажется, связано это в первую очередь с появлением очень большого количества доступной каждому текстовой информации и появлением соответствующих таким объемам вычислительных мощностей. Для задач data mining входной информацией являются некоторые объекты с небольшим числом свойств, на основании которых делаются определенные выводы. Например, объектом может быть история болезни, свойствами — результаты анализов и осмотров, а выводы, соответственно, диагноз. Системы text mining оперируют с набором документов, слова из которых можно аналогичным образом считать свойствами. При этом размер таких документов может быть очень большим (несколько тысяч слов), а размер общего словаря по всем документам может достигать нескольких сотен тысяч слов. Здесь нужно отметить одно важное свойство набора документов: если представить его в виде матрицы документ-слово (где элемент aij равен 1, если слово j содержится в документе i и 0 в противном случае), мы увидим, что она имеет сильно разреженную структуру, то есть большинство элементов равно 0. Это позволяет создавать эффективные (по памяти и скорости) алгоритмы обработки очень больших объемов данных.

Задачи text mining

  1. Классификация (classification). Задача заключается в отнесении документа к одной из нескольких заранее определенных категорий, основываясь на содержании документа. Для построения классификаторов используется обучающая выборка из документов с присвоенными им категориями. Классический пример: классификация писем по категориям спам/не спам. Самые простые классификаторы: метод k ближайших соседей и классификатор Байеса.
  2. Кластеризация (clustering) отличается от классификации тем, что мы не знаем какие существуют категории. У нас нет никакой обучающей выборки, есть только документы, которые надо попытаться определенным образом сгруппировать в кластеры (категории). Причем, как правило, неизвестно даже число возможных категорий (хотя его можно более-менее точно оценить. Существует два типа алгоритмов кластеризации: одни работают с заранее определенным числом категорий (например, алгоритм k-средних), другие с неизвестным (например, иерархическая кластеризация). Известные примеры использования кластеризации: Яндекс.Новости и Nigma.
  3. Извлечение фактов (fact/information extraction). Название говорит за себя, задача заключается в извлечении из неструктурированного текста информации определенного вида, например пресс-портрета или цитат.
В следующих постах расскажу подробно о каждой из задач.

пятница, декабря 01, 2006

Text Mining Books

Хочу порекомендовать вам две замечательные книги по text mining.
  1. Text Mining: Predictive Methods for Analyzing Unstructured Information (Sholom M. Weiss, Nitin Indurkhya, Tong Zhang, Frederick Damerau). Эта книга — краткое, но в то же время достаточно полное введение в text mining. Подготовка данных, классификация, кластеризация, поиск, извлечение информации — всему нашлось место в книге, причем некоторые алгоритмы описаны очень подробно. Самой интересной мне показалась шестая глава, посвященная статистическим методам в извлечении информации (information extraction). Резюме: специалистам в text mining книга поможет структурировать имеющийся объем знаний, для новичков же она прекрасное введение в область.
  2. Survey of Text Mining: Clustering, Classification, and Retrieval (под редакцией Michael W. Berry). Здесь собраны лучшие работы участников Text Mining Workshop проведенного в рамках Second SIAM International Conference on Data Mining (SDM) в 2002-ом году. Наиболее интересные, на мой взгляд: мягкий (soft) алгоритм k-средних с автоматической расстановкой весов отдельным словам, алгоритмы кластеризации PDDP (Principal Direction Divisive Partitioning) и sPDDP( spherical PDDP), Latent Semantic Indexing и Covariance Matrix Analysis (известный также как Principal Component Analysis) и их модификации для лучшей обработки маленьких кластеров. Три перечисленных алгоритма кластеризации (кроме LSI) используют по сути один и тот же метод: нахождение одного или нескольких собственных векторов матрицы ковариантности. Чуть позже напишу об этом подробнее, это действительно очень интересно.
Стоит отметить, что 28-апреля 2007-го года в рамках очередной SDM пройдет Text Mining Workshop, лучшие работы с которого будут опубликованы во втором издании Survey of Text Mining. Работы принимаются до 8-го января.

понедельник, ноября 20, 2006

Multiword Features

В ситуациях когда различиях между категориями проявляются не на уровне различных слов, а на уровне сочетаний этих слов, классические классификаторы Байеса могут показывать не очень удовлетворительные результаты. Справиться с этой проблемой можно используя шинглы (shingles) или multiword features.

В общем случае, шинглы — это уникальные последовательности символов одинаковой длины выделенные из документа. Для задач классификации можно рассматривать последовательности не символов, а слов. Например, для документа "a rose is a rose is a rose" шинглами длиной в четыре слова будут: { (a,rose,is,a), (rose,is,a,rose), (is,a,rose,is) }. Построить все шинглы для документа можно за O(w(n-w)), где w — длина шингла. Дальше шинглы используются как обычные слова в классификаторе Байеса, за счет чего заметно вырастает точность, особенно когда мы работаем с иерархической структурой категорий.

К сожалению шинглы нам не помогут в случае, когда слова из характерных сочетаний идут в документах не подряд, а на различном расстоянии друг от друга. В таком случае можно использовать обобщение идеи шинглов: multiword features. Собственно, что это такое уже понятно, весь вопрос в том, как эффективно эффективно найти характерные для категории multiword features. Действительно, наивный алгоритм, который находит все возможные сочетания слов, скорее всего просто не влезет в память. Очевидно, что нам нужны не все возможные сочетания слов, а только наиболее характерные для категории, то есть которые встречаются, например, как минимум в 10% документов. Это позволяет нам последовательно вычислять корреляцию для очередного набора слов и хранить в памяти только удовлетворяющие условию. Тем не менее, временная сложность такого алгоритма все равно будет O(mk), где m — число слов в категории, k — число слов в наборе. Очевидно, что вычислять наборы более чем из двух слов неэффективно, да и, как правило, это не даст большого выигрыша в точности.

Таким образом, нам осталось решить задачу вычисления корреляции между двумя словами в наборе документов, то есть число документов, в которых эти слова встречаются одновременно. Опять же, самый простой способ, когда мы проходим все документы и считаем вхождения слов в них будет достаточно медленным. Можно использовать следующий алгоритм вычисления корреляции:
  1. Каждое слово представляется вектором, элементы которого равны нулю или единице, в зависимости от присутствия слова в документе с соответствующим номером.
  2. Этот вектор хранится в виде long[], длина массива равна [n / sizeof(long)] + 1, где n — число документов.
  3. Вычисление корреляции между двумя документами сводится к последовательному побитовому умножению элементов двух массивов и вычислению числа единиц в результате.
Хороший практический результат на многих задачах может дать совместное использование шинглов длиной в 3-5 слов и 2-word features.

суббота, октября 21, 2006

Метод k-средних для обучения классификаторов Байеса

Алгоритм k-средних (k-means clustering) — очень быстрый, простой и достаточно точный метод кластеризации объектов. Идея заключается в минимизации суммарного отклонения по каждому кластеру:
Здесь, Si — k кластеров, μi — центроид i-го кластера. На каждой итерации алгоритма мы перемещаем каждый вектор в кластер с ближайшим центроидом. Хотя не существует каких-либо оценок сложности алгоритма, на практике хватает он сходится за достаточно малое число итераций.

У метода k-средних есть два серьезных недостатка:
  1. Необходимо заранее знать точное число кластеров.
  2. Качество результата сильно зависит от выбора начального разбиения.
Поэтому, обычно, сначала применяют какой-либо другой метод кластеризации (например, Principal Direction Divisive Partitioning) для определения числа кластеров и получения начального разбиения.

Что будет если применить метод k-средних к задаче обучения классификаторов Байеса на некачественных данных? Действительно, ведь у нас уже есть готовы набор категорий-кластеров и начальное разбиение по ним. Я провел простой эксперимент. Тестовый набор включал в себя три категории документов, условно их можно назвать "Information Retrieval" (С1), "Java" (C2) и "HTML" (C3). Сами документы представляют собой короткие (несколько предложений) отрывки из статей в Википедии. Обучающую выборку я составил следующим образом: к каждой категории были отнесены 100 документов из нее самой и по 15 документов из двух других. После чего я применил Байеса ко всем 390 документам: 62 из них были классифицированны неправильно. Алгоритм k-средних разложил документы в обучающей выборке следующим образом:
C1 = 129 * C1 + 2 * C2
C2 = 1 * C1 + 127 * C2 + 4 * C3
C3 = 1 * C2 + 126 * C3
Заново обученный Байес ошибся уже всего в 5 случаях!

среда, октября 18, 2006

Байес для сужения области поиска

Одним из главных достоинств классификаторов Байеса является скорость работы. Это позволяет использовать их для сужения области работы другого, более сложного и затратного механизма классификации и распознования. Идея очень простая: мы обрабатываем входные данные Байесом и выбираем k результатов с наибольшей вероятностью, среди которых уже ищем окончательный ответ.

Если копнуть чуть глубже, с помощью такого метода можно превратить линейную зависимость скорости работы самого Байеса от числа категорий в логарифмическую. Для этого надо построить классификатор похожий на decision tree, в котором решение в узлах будет приниматься с помощью Байеса. Формула для расчета вероятностей в таком классификаторе остается точно такой же, мы просто подставляем туда другие данные. Если объект принадлежит какой-либо категории, то он принадлежит и всем ее родителям, соответственно, слово описывающее объект также принадлежит всем родителям категории. При этом вероятность для каждого слова в категории надо считать относительно "братьев" этой категории, а не всех категорий сразу.

Есть еще один момент отличающий полученный классификатор от decision tree. Из каждого узла мы спускаемся вниз не по одному направлению, а сразу по нескольким, наиболее вероятным. Это нужно, чтобы не потерять маленькие категории внутри больших.

Результатом работы этого классификатора будет набор категорий, которые были им пройдены в спуске по дереву. Дальше мы применяем классического Байеса к этому набору и получаем искомый ответ за гораздо меньшее время.

пятница, октября 13, 2006

Обучение классификатора на некачественных данных

В идеальном мире все наши данные точные и полные, в них нет ошибок, пользователи счастливы, а специалисты по data quality торгуют пирожками. Как вы уже догадались, мы живем далеко не в идеальном мире и у наших данных большие проблемы с качеством. Эти проблемы встают особенно остро, когда мы хотим использовать эти данные для обучения систем наподобие классификаторов Байеса. Ведь все очень просто, правильные знания, скорее всего, дадут правильный результат, неправильные — совершенно непредсказуемый.

Напомню нашу задачу. Необходимо классифицировать некие сущности (например, книги или вообще любые товары) по дереву категорий. Для обучения у нас есть некоторый входной массив данных. Нас подстерегают две проблемы с качеством:
  1. Неточная или неправильная классификация сущностей по категориям.
  2. Само дерево категорий может недостаточно точно и/или избыточно отражать реальный мир.
Вторая задача достаточно сложная и достойна отдельного исследования, первую же можно решить достаточно просто и эффективно.

Первое, что необходимо сделать (если это возможно, конечно), это попытаться выделить каким-либо образом среди всего обучающего массива записи, которые отклассифицированы правильно. Как правило, для этого используются какие-либо внешние источники данных или результаты обработки массива другой системой. Все, конечно, сильно зависит от конкретного случая. После выделения таких записей, словам из них можно дать больший вес, например, умножить их частоту встречаемости на 2.

Если же у нас не очень много данных (или очень много свободного времени), их можно вообще классифицировать вручную. Не очень много это, действительно, не очень много, у меня не получалось заставить себя обработать больше двух тысяч записей. Соответственно, для больших массивов нам нужно попытаться сделать некоторую выборку таким образом, чтобы в нее попало как можно большее число плохих записей. Использовать в качестве критерия "нехорошести" итоговую вероятность не получится, как большие, так и маленькие ее значения в данном случае очень мало говорят о качестве результата классификации. Гораздо лучшей выборкой оказываются те записи, для которых полученная категория отличается от исходной. На практике, размер такой выборки может быть от 1 до 10 процентов от общего числа обучающих записей. Что же она поможет нам узнать:
  1. Если классификатор сработал правильно, можно предположить, что большая часть подобных записей уже лежит в правильной категории. Для слов из этой записи можно немного повысить вес, пометить ее как "подтвержденную".
  2. Если же классификатор выдал неправильный результат, как правило, это означает обратное: значительной части похожих записей присвоена неправильная категория. Чтобы как можно быстрее вытащить их на белый свет, стоит повысить вес для слов гораздо сильнее, чем в предыдущем случае. На практике, хороший результат достигался умножением на 25.
Результаты такой обработки загружаются в базу знаний, меняются категории у записей, помечается как нужно повысить вес и повторно запускается классификатор. Далее мы делаем точно такую же выборку, которая может быть чуть больше предыдущей, и повторям процесс обработки. Чтобы добиться хороших результатов, обычно достаточно 4-5 таких циклов.

Если данных совсем много, можно применить несколько приемов, которые помогут ускорить процесс обработки:
  1. Выборку можно разделить на две части. Первая, где произошло уточнение категории, то есть мы спустились ниже по дереву. Эта часть обрабатывается гораздо быстрее, так как проще принять решение о правильности результата. Вторая — все остальное. Обработать ее будет тоже чуть проще, потому что она станет значительно меньше.
  2. Можно отдельно стрелять классификатором по подозрительным категориям. Это, в первую очередь, категории, в которые записи были ошибочно отнесены. Так мы сможем достаточно быстро выявить большие некачественные регионы в обучающем массиве.

среда, октября 11, 2006

Классификация по Байесу

Свой классификатор Байеса, кажется, не написал только ленивый. На удивление простая модель с допущениями, от которых у любого математика начинают шевелиться уши, на практике работает с потрясающей точностью. Определение спама, классификация текстов по жанрам, товарных предложений по категориям или даже поиск модели ноутбука в наборе строк — со всеми этими задачами успешно справляются классификаторы Байеса.

Расскажу на примере как работает самый простой классификатор Байеса. Допустим, мы хотим классифицировать книги на основе их краткого описания. У нас есть исходная база знаний в виде дерева категорий и набора уже классифицированных книг. На основе этих данных мы можем посчитать для каждого слова, которое встречается в описаниях, вероятность его принадлежности к определенной категории по следующей формуле:
W — слово, C — категория
count(C, W) — количество слов W в описаниях книг из категории C
count(C, books) — количество книг в категории C

Нормализация по числу книг нужна, чтобы не терять в общей массе маленькие категории с большой встречаемостью слова. Например, в категории C1 "Тракторы в поэзии 20-го века" есть 30 книг, в описаниях которых слово "трактор" встречается 60 раз. А в категории C2 "Спецтехника", соответственно, 6000 книг и 1000 раз встречается слово "трактор". Таким образом, без нормализации:
P(C1, "трактор") = 60 / (1000 + 60) ~ 0.056
P(C2, "трактор") = 1000 / (1000 + 60) ~ 0.944
Что однозначно относит слово "трактор" в категорию С2. Если использовать нормализацию, мы получаем:
P(C1, "трактор") ~ 0.925
P(C2, "трактор") ~ 0.075
Эти числа уже гораздо ближе к жизни.

Посчитав вероятности для каждого слова из нашей базы знаний, мы готовы классифицировать книги. Вероятность принадлежности книги book к категории C равна:

Здесь P(C) это априорная вероятность встречаемости категории C, которая равна отношению числа книг в C к общему числу книг. С помощью этого множителя мы учитываем, что книги о "Спецтехнике" встречаются гораздо чаще, чем "Тракторы в поэзии". Необходимо отметить, что P(C|word) может быть нулем, если слово не встретилось в категории ни одного раза, в таком случае обычно подставляют в формулу какое-либо маленькое значение.

Все! Классификатор Байеса готов работе. В следующий раз я расскажу о некоторых методиках обучения на некачественных данных и о двух интересных способах применения полученного классификатора.