Практические советы по реализации систем извлечения информации

Показаны сообщения с ярлыком mtj. Показать все сообщения

пятница, ноября 24, 2006

SparseArrayList

Бывают такие ситуации, когда стандартный HashMap слишком медленный и затратный по памяти, а возможностей SparseVector из MTJ не хватает, поскольку надо хранить произвольные объекты. Для таких случаев я написал простой класс SparseArrayList, который практически идентичен SparseVector за вычетом, собственно, векторных операций. Плюс для хранения данных используется не массив, а ArrayList, и размер контейнера не ограничивается в конструкторе.

В архиве лежит еще и класс Arrays (дополнение к стандартному) из MTJ. В библиотеке он package-local, для реализации SparseArrayList пришлось сделать его public.

понедельник, ноября 06, 2006

Eigenvalue Decomposition

После более детального исследования оказалось, что других хороших библиотек кроме Matrix Toolkits for Java для работы с матрицами и векторами на Java попросту нет. Ни по набору функций, ни по производительности. MTJ построена поверх BLAS/LAPACK и может использовать оптимизированные под определенную платформу реализации этих библиотек (инструкции для Linux и Windows).

Достаточно часто в задачах IR требуется найти собственные вектора какой-либо матрицы nxn (eigenvalue decomposition, EVD), причем обычно нам нужны только k << n векторов соответствующих k наибольшим собственным числам матрицы. Но существующие в MTJ классы для вычисления EVD находят сразу все вектора, что приводит к совершенно неоправданным временным затратам. Для решения этой задачи я немного модифицировал класс SymmDenseEVD, который находит собственные вектора у симметричной матрицы. Теперь в конструкторе можно задать какие собственные числа (по убыванию) и соответствующие им вектора нам нужны.

Binaries: mtj.jar
Source code: mtj-src.tar.gz

вторник, октября 31, 2006

Не делайте лишнего

В реализации алгоритма k-средних основная операция — вычисление расстояния между двумя векторами ||a - c||. Очевидный способ это сделать, используя библиотеку MTJ
new SparseVector(vector).add(-1, centroid).norm(Vector.Norm.Two)
Увидев в профайлере, что на метод add() приходится около 90% всех вычислений, возникает естественное желание попытаться его ускорить. Как работает этот метод? Для этого нам надо понять, как вообще устроен SparseVector.

Для хранения разреженного вектора заводится два массива: массив индексов и массив значений.

index

12

15

86

87

90

125

234

235

value

1.42

1.2

0.01

0.43

1.23

2.41

2.55

0.143

Индексы отсортированы по возрастанию. При чтении элемента вектора бинарным поиском ищется его индекс, потом выбирается соответствующий индексу элемент из массива значений. Запись элемента происходит следующим образом: если по этому индексу уже есть элемент, то он просто перезаписывается, если же элемента нет, то оба массива раздвигаются в нужном месте (при необходимости увеличивается их длина) и сохраняется новый индекс и значение для него.

Как можно складывать такие вектора? Самый очевидный способ (который и реализован в классе SparseVector) выглядит так:
public void add(int index, double value) {
check(index);

int i = getIndex(index);
data[i] += value;
}

В getIndex() ищется место индекса в массиве и, при необходимости, создается место под новый. Его алгоритмическая сложность O(log(n)), где n длина вектора, к которому мы добавляем. При этом нельзя забывать о достаточно большой константе связанной с раздвижением массива. Соответственно, общая сложность получается O(m log(n)), где m длина вектора, который мы добавляем.

Конечно же, сразу хочется реализовать сложение векторов с помощью слияния двух массивов за O(m + n). Вот только для некоторых m и n такое слияние будет даже медленнее чем первый способ. Например, для n = 100 и m = 20 (самые обычные значения во многих задачах).

Как же нам улучшить производительность вычисления нормы разности векторов? Ответ прост, нам же совершенно не нужно вычислять разность векторов, это лишняя операция. Надо лишь на каждом шаге алгоритма слияния массивов вычислять очередное слагаемое нормы. Так мы избавляемся от затратной операции записи в массив и лишней операции чтения. После такой оптимизации скорость работы выросла в 3-4 раза.

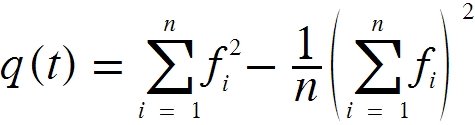
воскресенье, октября 22, 2006

Реализация алгоритма k-средних

Документы-вектора можно представить несколькими способами, выбрав разные значения в качестве их элементов:

  1. 0 или 1, в зависимости от наличия слова в документе
  2. Число слов в документе
  3. TF*IDF данного слова
Как правило для документов с малым числом слов (или же просто с набором атрибутов) лучше подходят первые два способа, а для более-менее больших документов на естественном языке TF*IDF.

Полученную сильно разреженную матрицу надо не только хранить в памяти, но и иметь возможность эффективно выполнять разные операции над ними. Библиотек для работы со sparse matrices на Java не так много, а самое плохое, что я не нашел никаких benchmarks. Достаточно удобной в использовании мне показалась Matrix Toolkits for Java.

Радикально ускорить алгоритм можно с помощью уменьшения словаря, убрав из него слова мало влияющие на результат. Как правило, достаточно всего 20-30% слов, чтобы алгоритм работал с практически такой же точностью. Один из самых простых cпособов уменьшения словаря состоит в том, чтобы выбирать слова с наибольшей функцией качества:
n — число всех документов
fi — частота встречаемости слова в i-ом документе.

Существует некий порог размера словаря, начиная с которого алгоритм k-средних начинает работать очень плохо. Обычно он лежит как раз в диапазоне 20-30%. Нужный размер проще всего подобрать экспериментальным путем.