Практические советы по реализации систем извлечения информации

Показаны сообщения с ярлыком clustering. Показать все сообщения

среда, января 03, 2007

Hakia — поиск смысла

Продолжая тему кластерного поиска. Новый поисковик Hakia (http://www.hakia.com) делает, пожалуй, самые интересные шаги в этом направлении. "The basic promise is to bring search results by meaning match - similar to the human brain's cognitive skills - rather than by the mere occurrence (or popularity) of search terms."

Я, конечно же, захотел проверить Hakia на своем любимом запросе "nokia 6230i". К моему удивлению, я увидел самую обыкновенную плоскую выдачу! Вернее, почти обыкновенную. В сниппетах выделены не просто ключевые слова запроса, а иногда и целые предложения или их части. Например, "The Nokia 6230i imaging phone combines advanced image and video features", "downloads and customer service information for your Nokia 6230i phone.", "to separate the Nokia 6230i from the 6230 apart from the vastly improved joystick" и др. Видно, что Hakia пытается понять о чем страница и показать самый релевантный смыслу страницы кусок в сниппете (не забывая, конечно, о поисковом запросе). Вполне возможно, это может сэкономить некоторое время — надо читать не весь сниппет, а заранее выделенный кусок — чтобы это проверить, надо попользоваться Hakia подольше.

Где же обещанный кластерный поиск? На наш запрос "nokia 6230i" маленькая зеленая голова под строкой поиска ответила (текст выбирается случайно): "Tough question! See if the results below help. ...See the hakia gallery for Nokia". Идем по ссылке (запрос "Nokia"), первая страница выдачи это, так называемая, галерея — набор кластеров с двумя ссылками в каждом. Headlines; Stock Quote and Company Website ; News, Company Profile; Company Heritage; Press Releases; Investors Page; Corporate Leadership; Employment and Career Opportunities; Brands; Industry and Peers; Criticism, Commentary, and Interpretations; Community Outreach and Philanthropy; Location and Contact Information — кластера хорошие, с правильными названиями и правильными ссылками в них. Смущают только две вещи. Во-первых, hakia gallery выдается не по всем запросам. Во-вторых, я не нашел способа посмотреть что еще есть в том или ином кластере. Имя кластера это не ссылка, а если набрать запрос "Nokia headlines", мы увидим совсем не те новости, которые нам предлагали в галерее.

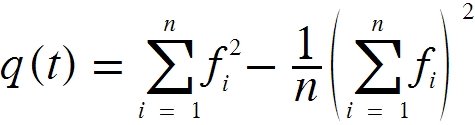
воскресенье, декабря 03, 2006

Что такое text mining

Решил написать небольшую серию постов, некоторое введение в text mining. Что это такое, какие задачи ставятся, как решаются, какие направления сейчас развиваются. Начну с общего обзора.

Text mining, в отличие от своего старшего брата data mining, сравнительно молодая область computer science, большинство значительных результатов было получено в последние 10-15 лет. Как мне кажется, связано это в первую очередь с появлением очень большого количества доступной каждому текстовой информации и появлением соответствующих таким объемам вычислительных мощностей. Для задач data mining входной информацией являются некоторые объекты с небольшим числом свойств, на основании которых делаются определенные выводы. Например, объектом может быть история болезни, свойствами — результаты анализов и осмотров, а выводы, соответственно, диагноз. Системы text mining оперируют с набором документов, слова из которых можно аналогичным образом считать свойствами. При этом размер таких документов может быть очень большим (несколько тысяч слов), а размер общего словаря по всем документам может достигать нескольких сотен тысяч слов. Здесь нужно отметить одно важное свойство набора документов: если представить его в виде матрицы документ-слово (где элемент aij равен 1, если слово j содержится в документе i и 0 в противном случае), мы увидим, что она имеет сильно разреженную структуру, то есть большинство элементов равно 0. Это позволяет создавать эффективные (по памяти и скорости) алгоритмы обработки очень больших объемов данных.

Задачи text mining

  1. Классификация (classification). Задача заключается в отнесении документа к одной из нескольких заранее определенных категорий, основываясь на содержании документа. Для построения классификаторов используется обучающая выборка из документов с присвоенными им категориями. Классический пример: классификация писем по категориям спам/не спам. Самые простые классификаторы: метод k ближайших соседей и классификатор Байеса.
  2. Кластеризация (clustering) отличается от классификации тем, что мы не знаем какие существуют категории. У нас нет никакой обучающей выборки, есть только документы, которые надо попытаться определенным образом сгруппировать в кластеры (категории). Причем, как правило, неизвестно даже число возможных категорий (хотя его можно более-менее точно оценить. Существует два типа алгоритмов кластеризации: одни работают с заранее определенным числом категорий (например, алгоритм k-средних), другие с неизвестным (например, иерархическая кластеризация). Известные примеры использования кластеризации: Яндекс.Новости и Nigma.
  3. Извлечение фактов (fact/information extraction). Название говорит за себя, задача заключается в извлечении из неструктурированного текста информации определенного вида, например пресс-портрета или цитат.
В следующих постах расскажу подробно о каждой из задач.

пятница, декабря 01, 2006

Text Mining Books

Хочу порекомендовать вам две замечательные книги по text mining.
  1. Text Mining: Predictive Methods for Analyzing Unstructured Information (Sholom M. Weiss, Nitin Indurkhya, Tong Zhang, Frederick Damerau). Эта книга — краткое, но в то же время достаточно полное введение в text mining. Подготовка данных, классификация, кластеризация, поиск, извлечение информации — всему нашлось место в книге, причем некоторые алгоритмы описаны очень подробно. Самой интересной мне показалась шестая глава, посвященная статистическим методам в извлечении информации (information extraction). Резюме: специалистам в text mining книга поможет структурировать имеющийся объем знаний, для новичков же она прекрасное введение в область.
  2. Survey of Text Mining: Clustering, Classification, and Retrieval (под редакцией Michael W. Berry). Здесь собраны лучшие работы участников Text Mining Workshop проведенного в рамках Second SIAM International Conference on Data Mining (SDM) в 2002-ом году. Наиболее интересные, на мой взгляд: мягкий (soft) алгоритм k-средних с автоматической расстановкой весов отдельным словам, алгоритмы кластеризации PDDP (Principal Direction Divisive Partitioning) и sPDDP( spherical PDDP), Latent Semantic Indexing и Covariance Matrix Analysis (известный также как Principal Component Analysis) и их модификации для лучшей обработки маленьких кластеров. Три перечисленных алгоритма кластеризации (кроме LSI) используют по сути один и тот же метод: нахождение одного или нескольких собственных векторов матрицы ковариантности. Чуть позже напишу об этом подробнее, это действительно очень интересно.
Стоит отметить, что 28-апреля 2007-го года в рамках очередной SDM пройдет Text Mining Workshop, лучшие работы с которого будут опубликованы во втором издании Survey of Text Mining. Работы принимаются до 8-го января.

вторник, ноября 28, 2006

Контроль над поисковой выдачей

Nigma первой в рунете сделала удивительно полезную вещь: возможность управлять результатами поиска в зависимости от цели запроса. Не секрет, что большинство интернет-магазинов очень хорошо оптимизированы и занимают первые места в выдаче, хотя нам очень часто нужна только информация о товаре, обзоры, отзывы с форумов. Теперь при поиске в Нигме есть возможность отключать целые кластеры результатов, например "интернет-магазины".

Стоит отметить, что Yahoo запустил подобную поиск больше года назад и он как раз целиком направлен на исключение (или включение) магазинов из результатов.

Дальнейшим развитием этой идей должны быть уточняющие вопросы, то есть при запросе "слон" у пользователя должны спросить "вы хотите купить слона, посмотреть на слона или узнать про слона?" и, в зависимости от ответа, отсортировать результаты.

воскресенье, октября 22, 2006

Реализация алгоритма k-средних

Документы-вектора можно представить несколькими способами, выбрав разные значения в качестве их элементов:

  1. 0 или 1, в зависимости от наличия слова в документе
  2. Число слов в документе
  3. TF*IDF данного слова
Как правило для документов с малым числом слов (или же просто с набором атрибутов) лучше подходят первые два способа, а для более-менее больших документов на естественном языке TF*IDF.

Полученную сильно разреженную матрицу надо не только хранить в памяти, но и иметь возможность эффективно выполнять разные операции над ними. Библиотек для работы со sparse matrices на Java не так много, а самое плохое, что я не нашел никаких benchmarks. Достаточно удобной в использовании мне показалась Matrix Toolkits for Java.

Радикально ускорить алгоритм можно с помощью уменьшения словаря, убрав из него слова мало влияющие на результат. Как правило, достаточно всего 20-30% слов, чтобы алгоритм работал с практически такой же точностью. Один из самых простых cпособов уменьшения словаря состоит в том, чтобы выбирать слова с наибольшей функцией качества:
n — число всех документов
fi — частота встречаемости слова в i-ом документе.

Существует некий порог размера словаря, начиная с которого алгоритм k-средних начинает работать очень плохо. Обычно он лежит как раз в диапазоне 20-30%. Нужный размер проще всего подобрать экспериментальным путем.

суббота, октября 21, 2006

Метод k-средних для обучения классификаторов Байеса

Алгоритм k-средних (k-means clustering) — очень быстрый, простой и достаточно точный метод кластеризации объектов. Идея заключается в минимизации суммарного отклонения по каждому кластеру:
Здесь, Si — k кластеров, μi — центроид i-го кластера. На каждой итерации алгоритма мы перемещаем каждый вектор в кластер с ближайшим центроидом. Хотя не существует каких-либо оценок сложности алгоритма, на практике хватает он сходится за достаточно малое число итераций.

У метода k-средних есть два серьезных недостатка:
  1. Необходимо заранее знать точное число кластеров.
  2. Качество результата сильно зависит от выбора начального разбиения.
Поэтому, обычно, сначала применяют какой-либо другой метод кластеризации (например, Principal Direction Divisive Partitioning) для определения числа кластеров и получения начального разбиения.

Что будет если применить метод k-средних к задаче обучения классификаторов Байеса на некачественных данных? Действительно, ведь у нас уже есть готовы набор категорий-кластеров и начальное разбиение по ним. Я провел простой эксперимент. Тестовый набор включал в себя три категории документов, условно их можно назвать "Information Retrieval" (С1), "Java" (C2) и "HTML" (C3). Сами документы представляют собой короткие (несколько предложений) отрывки из статей в Википедии. Обучающую выборку я составил следующим образом: к каждой категории были отнесены 100 документов из нее самой и по 15 документов из двух других. После чего я применил Байеса ко всем 390 документам: 62 из них были классифицированны неправильно. Алгоритм k-средних разложил документы в обучающей выборке следующим образом:
C1 = 129 * C1 + 2 * C2
C2 = 1 * C1 + 127 * C2 + 4 * C3
C3 = 1 * C2 + 126 * C3
Заново обученный Байес ошибся уже всего в 5 случаях!